Onderzoek · 8 oktober 2026
Dezelfde aankoopvraag levert bij chatbots deels andere merken op
60 Nederlandse aankoopvragen zonder merknaam, elk 8 keer op dezelfde dag gesteld via de API's van ChatGPT, Gemini en Perplexity. Daarnaast 20 vragen die we elk 20 keer stelden.
Matt Timmermans, Timmermans Media. Meting: 26 september 2026. Preregistratie: doi.org/10.5281/zenodo.22974863. Data: doi.org/10.5281/zenodo.23010967.
Wie een chatbot twee keer exact dezelfde aankoopvraag stelt, krijgt deels andere merken te zien. Van alle merken die in twee antwoorden samen voorkwamen, stond gemiddeld 47% in beide bij ChatGPT, 52% bij Gemini en 38% bij Perplexity. Ook het merk dat als eerste werd genoemd, was in ongeveer de helft van de gevallen een ander.
Eén antwoord, of een screenshot ervan, is dus onvoldoende om te bepalen hoe vaak een merk wordt genoemd. Dat geldt ook voor drie herhalingen: bij gemiddeld ongeveer een kwart van de merken per vraag week een schatting uit drie antwoorden sterk af van een schatting uit twintig. De uitkomsten gelden voor de API's op 26 september 2026; de apps zijn niet onderzocht.
De uitkomsten
Merkvermeldingen bij herhaalde vragen: vier cijfers
47%, 52% en 38%:
zoveel van de merken uit twee antwoorden op dezelfde aankoopvraag stond gemiddeld in beide, bij ChatGPT, Gemini en Perplexity.
Ongeveer de helft:
in 50 tot 52% van de antwoordparen werd hetzelfde merk als eerste genoemd.
19 tot 26%:
bij zoveel van de merken per vraag zat een schatting uit drie herhalingen meestal meer dan 20 procentpunt naast een schatting uit twintig.
17 tot 27%:
zoveel overlap in merken was er tussen twee verschillende chatbots op dezelfde vraag, tegenover 39 tot 44% tussen herhalingen van dezelfde chatbot.
Herhaling
Hoeveel merken komen terug als je dezelfde vraag opnieuw stelt?
Minder dan de helft tot iets meer dan de helft. Bij herhaling van dezelfde aankoopvraag was de gemiddelde overlap in genoemde merken 47% bij ChatGPT, 52% bij Gemini en 38% bij Perplexity.
Wat overlap hier betekent: het aantal merken dat in beide antwoorden voorkomt, gedeeld door het aantal verschillende merken in de twee antwoorden samen. Voorbeeld: antwoord 1 noemt Moneybird, e-Boekhouden.nl en Exact, antwoord 2 noemt Moneybird, Exact en Jortt. Twee merken komen in beide voor, vier merken in totaal. De overlap is dan 2 van de 4, oftewel 50%. Een overlap van 50% betekent dus niet dat de helft van de merken uit het eerste antwoord verdwijnt.
| Chatbot | Gemiddelde overlap | 95%-interval | Gemiddeld aantal merken per antwoord | Bruikbare aankoopvragen |
|---|---|---|---|---|
| ChatGPT | 47% | 43 tot 50% | 2,2 | 52 van 60 |
| Gemini | 52% | 49 tot 55% | 7,1 | 58 van 60 |
| Perplexity | 38% | 34 tot 42% | 4,0 | 56 van 60 |
60 aankoopvragen, 8 herhalingen per vraag, alle 28 paren van herhalingen per vraag. Gewogen gemiddelde over 20 categorieën. Bij alle drie de chatbots zijn alle 20 categorieën vertegenwoordigd. Een vraag waarbij een chatbot in geen enkele herhaling een merk noemde, telt voor die chatbot niet mee. Een paar waarin één antwoord wel en het andere geen merk noemt, telt als 0% overlap. Laat je die paren weg, dan is de overlap 48% bij ChatGPT, 53% bij Gemini en 43% bij Perplexity (aanvullend, niet gepreregistreerd).
Gemini heeft in deze meting de hoogste overlap en noemt ook de meeste merken per antwoord, Perplexity de laagste overlap. We hebben de chatbots op deze maat niet met elkaar getoetst. Het aantal merken per antwoord verschilt bovendien sterk (2,2 tegenover 7,1), en dat beïnvloedt hoe hoog de overlap kan uitvallen.
Genoemd of aanbevolen. Dit onderzoek telt vermeldingen. Een antwoord dat een merk aanraadt en een antwoord dat hetzelfde merk afraadt, tellen als overeenkomend. Voor alleen de aanbevolen merken is de overlap vrijwel gelijk: 46% bij ChatGPT, 51% bij Gemini en 36% bij Perplexity. Of een merk is aanbevolen, heeft een taalmodel bepaald.
Omdat alle herhalingen op dezelfde dag en door elkaar heen zijn uitgevoerd, komen de verschillen niet door een modelupdate tussen twee meetdagen.
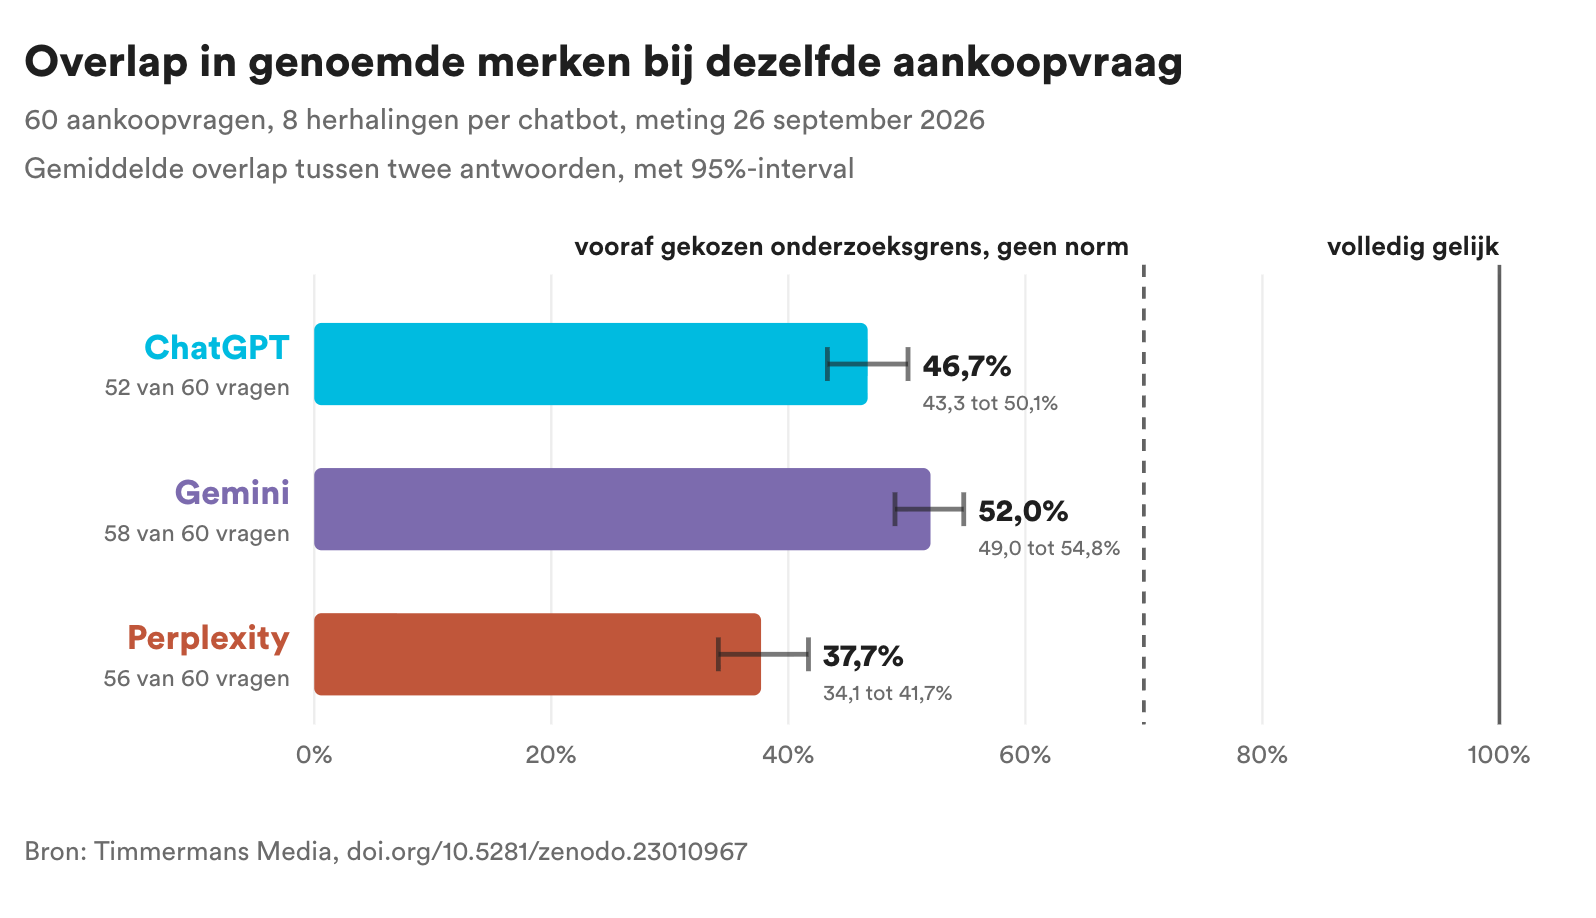
Grafiek 1. Gemiddelde overlap in genoemde merken tussen twee antwoorden op dezelfde aankoopvraag, met 95%-interval: ChatGPT 46,7% (43,3 tot 50,1%, 52 van 60 vragen bruikbaar), Gemini 52,0% (49,0 tot 54,8%, 58 van 60) en Perplexity 37,7% (34,1 tot 41,7%, 56 van 60). De lijn bij 70% is de vooraf gekozen onderzoeksgrens, geen norm; bij 100% zijn de merken in beide antwoorden volledig gelijk. 60 aankoopvragen, 8 herhalingen per chatbot, meting 26 september 2026.
Eerste vermelding
Hoe vaak noemen chatbots hetzelfde merk als eerste?
In ongeveer de helft van de gevallen. ChatGPT, Gemini en Perplexity noemden bij herhaling van dezelfde aankoopvraag in 50 tot 52% van de antwoordparen hetzelfde merk als eerste.
| Chatbot | Zelfde merk als eerste genoemd | 95%-interval | Paren niet meegeteld (een van beide zonder merk) |
|---|---|---|---|
| ChatGPT | 52% | 46 tot 58% | 16% |
| Gemini | 52% | 47 tot 57% | 6% |
| Perplexity | 50% | 43 tot 56% | 21% |
Zelfde 60 aankoopvragen en 8 herhalingen. Alleen paren waarin beide antwoorden minstens één merk noemen.
Dit is een gemiddelde over vragen. Bij sommige vragen noemen de chatbots vrijwel altijd dezelfde eerste naam, bij andere wisselt die sterk. Of het eerst genoemde merk ook het aanbevolen merk is, meet deze maat niet.
Steekproefgrootte
Hoe nauwkeurig meet je merkzichtbaarheid met drie antwoorden?
Een ruwe schatting. Bij 19 tot 26% van de merken per vraag zat een schatting uit drie herhalingen meestal meer dan 20 procentpunt naast een schatting uit twintig herhalingen. Een vast minimumaantal herhalingen geeft dit onderzoek niet.
Merkzichtbaarheid is hier het aandeel herhalingen waarin een merk wordt genoemd. Wordt een merk in 12 van de 20 antwoorden genoemd, dan is de merkzichtbaarheid 60%.
Voorbeeld: Batavus bij Perplexity
Perplexity noemde het fietsmerk Batavus in 8 van de 20 antwoorden op de vraag naar de beste elektrische fiets, een merkzichtbaarheid van 40%. Een meting met drie herhalingen komt dan uit op 0, 33, 67 of 100%, afhankelijk van welke drie antwoorden je toevallig hebt. In 612 van de 1.140 mogelijke combinaties (54%) zat die meting meer dan 20 procentpunt naast de 40%.
Dit zijn combinaties van dezelfde twintig antwoorden, geen 1.140 apart uitgevoerde metingen. Elk merk dat in 8 van de 20 antwoorden voorkomt, geeft precies deze verdeling. Het voorbeeld laat dus zien wat er gebeurt bij een kleine steekproef, niet dat Perplexity uitzonderlijk wisselvallig is.
Grafiek 2. In 612 van de 1.140 metingen (54%) zit de meting meer dan 20 procentpunt naast de 40%. Elk merk dat in 8 van de 20 herhalingen voorkomt, geeft precies deze verdeling.
Hoe vaak wijken drie antwoorden sterk af?
Voor 20 aankoopvragen, één per categorie, stelden we dezelfde vraag 20 keer aan elke chatbot. Daarna berekenden we de merkzichtbaarheid voor alle 1.140 mogelijke combinaties van drie uit die twintig herhalingen, en keken we per merk hoe vaak een schatting uit drie herhalingen meer dan 20 procentpunt afweek van de schatting uit twintig.
| Chatbot | Merken waarbij drie herhalingen meestal meer dan 20 procentpunt afwijken | Spreiding over de vragen |
|---|---|---|
| ChatGPT | 26% | 0 tot 67% |
| Gemini | 24% | 0 tot 43% |
| Perplexity | 19% | 0 tot 45% |
Gemiddelde per vraag, over 19 aankoopvragen per chatbot; bij één vraag per chatbot werd in twintig herhalingen geen enkel merk genoemd. “Meestal” betekent: bij meer dan de helft van de 1.140 combinaties.
Ook de schatting uit twintig herhalingen is een schatting, geen vaststaande waarde. Wel is die gebaseerd op veel meer antwoorden.
Wat dit betekent voor onze andere publicaties. In onze onderzoeken naar Reddit, Google-posities, Google-verkeer en llms.txt stelden we elke vraag drie keer per chatbot. Die publicaties beantwoorden andere vragen en combineren gegevens uit veel vragen of websites. Deze analyse bewijst niet dat drie herhalingen voor al die uitkomsten voldoende zijn; de onzekerheid moet per uitkomst worden beoordeeld. Bij die publicaties staan intervallen bij de hoofdcijfers, en cijfers per categorie en losse voorbeelden zijn als verkennend vermeld.
Tussen chatbots
Noemen ChatGPT, Gemini en Perplexity dezelfde merken?
Minder dan één chatbot met zichzelf. De overlap tussen twee verschillende chatbots was bij dezelfde vraag kleiner dan tussen herhalingen van dezelfde chatbot. Dat gold voor alle drie de paren.
| Paar | Overlap tussen de chatbots | Overlap binnen de chatbots, zelfde vragen | Verschil (95%-interval) | Bruikbare vragen |
|---|---|---|---|---|
| ChatGPT en Gemini | 17% | 44% | -28 procentpunt (-32 tot -23) | 64 |
| ChatGPT en Perplexity | 27% | 39% | -12 procentpunt (-15 tot -9) | 60 |
| Gemini en Perplexity | 24% | 42% | -17 procentpunt (-20 tot -15) | 68 |
Brede deelverzameling van 100 vragen (per categorie 3 aankoopvragen en 2 informatieve vragen), 8 herhalingen per chatbot. Alleen vragen waarbij beide chatbots minstens één merk noemen. Aankoopvragen en informatieve vragen gelijk gewogen. Verschillen zijn berekend op niet-afgeronde waarden. De overlap binnen de chatbots is per vraag het gemiddelde van de overlap bij herhalingen van elk van de twee chatbots, over dezelfde vragen als de kolom ervoor en met aankoopvragen en informatieve vragen gelijk gewogen; daarom wijkt die af van 47%, 52% en 38%, die alleen over aankoopvragen gaan. Alleen aankoopvragen: -30, -19 en -19 procentpunt.
ChatGPT en Gemini lijken het minst op elkaar: twee antwoorden van die twee chatbots op dezelfde vraag hebben gemiddeld 17% van hun merken gemeenschappelijk.
Hoeveel merken worden maar door één chatbot genoemd?
In de basismeting, met drie herhalingen per chatbot, werd 70% van de combinaties van merk en aankoopvraag maar bij één chatbot aangetroffen. 11% werd door alle drie genoemd.
| Aangetroffen bij | Aandeel van alle combinaties van merk en vraag | Gemiddeld per vraag |
|---|---|---|
| 1 chatbot | 70% | 11,3 merken |
| 2 chatbots | 19% | 3,1 merken |
| Alle 3 chatbots | 11% | 1,7 merken |
Alle 229 aankoopvragen, drie herhalingen per chatbot samengenomen. De telling is per vraag. Van de combinaties die maar bij één chatbot voorkwamen, kwam 65% van Gemini, 27% van Perplexity en 8% van ChatGPT (aanvullend, niet gepreregistreerd).
Gemini noemt veel meer merken per antwoord dan ChatGPT (7,1 tegenover 2,2) en levert het grootste deel van de combinaties die maar één chatbot noemt (65%). Ook in de deelverzameling van 60 aankoopvragen met 8 herhalingen per chatbot kwam 70% van de combinaties bij maar één chatbot voor (aanvullend, niet gepreregistreerd). Omdat daar zowel het aantal herhalingen als de vragen anders zijn, is dat geen zuivere test van de invloed van het aantal herhalingen.
Voor SEO-specialisten
Wat betekent dit voor het meten van merkzichtbaarheid?
Dat één antwoord onvoldoende is om te bepalen hoe vaak een merk wordt genoemd. Een merk dat in een screenshot ontbreekt, kan bij de volgende vraag wel genoemd worden, en andersom. Dit onderzoek geeft geen vast aantal herhalingen, wel een onderbouwing om anders te meten en te rapporteren.
| Werkzaamheden | Toepassing van dit onderzoek |
|---|---|
| Rapportage | Vermeld bij elk percentage hoeveel keer de vraag is gesteld, en geef bij voorkeur een interval. Een percentage uit één of drie antwoorden kan sterk afwijken van een schatting uit veel meer antwoorden. |
| Tools en bureaus beoordelen | Vraag hoeveel herhalingen een meting van merkzichtbaarheid gebruikt, en per chatbot. Een rapport zonder dat aantal is niet te beoordelen. |
| Concurrentieanalyse | Meet per chatbot. ChatGPT, Gemini en Perplexity noemden bij dezelfde vraag grotendeels andere merken. |
| Klantgesprekken | Behandel één screenshot van een klant (“ChatGPT noemt ons niet”) als één waarneming, niet als conclusie. |
| Resultaten interpreteren | Maak onderscheid tussen genoemd, als eerste genoemd en aanbevolen. Dit onderzoek meet vooral het eerste. |
| Monitoring | Trek uit één hogere of lagere uitkomst nog geen conclusie over het effect van je werk. Herhaal dezelfde vragen onder vergelijkbare omstandigheden en rapporteer de onzekerheid. |
Dit geldt voor Nederlandse aankoopvragen via de API's, gemeten op één dag. Hoe merkvermeldingen over weken of maanden verschuiven, hebben we niet gemeten.
Welke websites deze chatbots als bron gebruiken, lees je in ons onderzoek naar Reddit als AI-bron en ons onderzoek naar Google-posities en AI-bronnen. Of websites met weinig Google-verkeer geciteerd worden, lees je in ons onderzoek naar Google-verkeer van AI-bronnen, en wat llms.txt daarmee te maken heeft in ons onderzoek naar llms.txt.
Verdieping
Verdieping: verschillen per branche en op productniveau
De onderdelen hieronder zijn verkennend. Ze vullen het beeld aan, maar dragen de hoofdconclusie niet.
Stabiliteit per categorie
De overlap verschilt sterk per categorie. Bij sommige vragen noemen de chatbots steeds grotendeels dezelfde merken, bij andere wisselt het veel meer.
| Categorie | Overlap ChatGPT | Overlap Gemini | Overlap Perplexity |
|---|---|---|---|
| Software en SaaS | 79% | 69% | 54% |
| Huisdieren | 72% | 55% | 74% |
| Eten en drinken | 54% | 67% | 62% |
| Boekhouding en administratie | 54% | 63% | 53% |
| Opleiding en cursus | 26% | 41% | 28% |
| HR en personeel | 25% | 33% | 9% |
| Juridisch | 14% | 24% | 21% |
Selectie van opvallende categorieën. Per categorie maar 3 aankoopvragen, bij sommige chatbots minder. Geen intervallen per categorie, dus ruwe schattingen.
In deze selectie liggen de hoogste waarden bij software en huisdieren. De laagste waarden verschillen per chatbot: juridisch bij ChatGPT en Gemini, HR en personeel bij Perplexity. Met 3 vragen per categorie is dat een aanwijzing, geen vaststaand verschil tussen branches.
Overlap op productniveau
Kijk je naar producten in plaats van merken, zoals Nike Pegasus in plaats van Nike, dan is de overlap lager: 30% bij ChatGPT, 32% bij Gemini en 22% bij Perplexity.
Informatieve vragen
Bij informatieve vragen noemen de chatbots weinig merken. Daar is de overlap 31% bij ChatGPT, 36% bij Gemini en 21% bij Perplexity, maar op te weinig vragen (13 tot 27) voor een harde conclusie.
Verantwoording
Verantwoording: merkvermeldingen meten bij herhaalde vragen
Preregistratie en hypothesen
We hebben de onderzoeksvragen, hypothesen, meetinstellingen en analyseregels vastgelegd en openbaar gedeponeerd op Zenodo voordat de meting begon (DOI 10.5281/zenodo.22974863).
Amendementen, hypothesen, meetopzet, merkherkenning, rekenwijze en beperkingen
Na het deponeren zijn op 26 september 2026 twee regels aangepast, beide voordat er analyses waren gedaan: het ophalen van een tweede pagina Google-resultaten voor 88 zoektermen (amendement 1) en de indeling van websites waarvoor Ahrefs geen rang maar wel verkeer geeft (amendement 2). Deze publicatie gebruikt geen Google- of Ahrefs-gegevens; de amendementen raken deze cijfers dus niet. Beide staan in het amendementenlog in het datadepot.
| Hypothese | Inhoud | Soort | Uitkomst of schatting |
|---|---|---|---|
| H4a | Overlap in genoemde merken tussen herhalingen onder 70% (aankoopvragen) | Primair | Bevestigd voor ChatGPT, Gemini en Perplexity |
| H4a-bis | Zelfde maat voor aanbevolen merken | Secundair | 46% (41 tot 50) / 51% (48 tot 55) / 36% (32 tot 39) |
| H4b | Eerst genoemde merk in minder dan 70% van de paren gelijk | Secundair | 52% / 52% / 50% |
| H4c | Bij minstens 25% van de merken wijken drie herhalingen meer dan 20 procentpunt af van twintig | Secundair | 26% / 24% / 19% (beschrijvend, zonder interval) |
| H11 | Overlap tussen chatbots lager dan binnen chatbots | Secundair | -28 / -12 / -17 procentpunt (ChatGPT-Gemini, ChatGPT-Perplexity, Gemini-Perplexity) |
Volgorde van de schattingen: ChatGPT, Gemini, Perplexity.
De grens van 70% voor H4a hadden we vooraf gekozen: bij 70% overlap komt 30% van alle verschillende merken uit een antwoordpaar maar in één van beide antwoorden voor. Die grens is een keuze, geen algemene norm. Alle drie de chatbots liggen er duidelijk onder; de hypothese is bevestigd met een gecorrigeerde p-waarde van 0,0015 voor alle drie de chatbots.
Alleen de primaire hypothese krijgt een uitkomstlabel. Secundaire hypothesen rapporteren we als schatting, met interval waar beschikbaar. Verkennend of aanvullend zijn: de cijfers per categorie, op productniveau en voor informatieve vragen, en de cijfers die in de tekst zo zijn gemarkeerd.
Meetopzet
| Onderdeel | Invulling |
|---|---|
| Vragen | 400 Nederlandse vragen zonder merknaam in 20 categorieën. Voor deze publicatie: een brede deelverzameling van 100 vragen (per categorie 3 aankoopvragen en 2 informatieve vragen) en een diepe deelverzameling van 20 aankoopvragen (1 per categorie) |
| Herhalingen | Brede deelverzameling 8 keer per chatbot, diepe deelverzameling 20 keer per chatbot, elke keer in een nieuwe sessie. Basismeting: alle 400 vragen 3 keer per chatbot |
| Chatbots | ChatGPT (gpt-6-sol, OpenAI Responses API met web_search, locatie Nederland), Gemini (gemini-3.8-flash, Gemini API met Google Search), Perplexity (sonar, Agent API met web_search, locatie Nederland) |
| Instellingen | Geen systeeminstructie, standaardinstellingen |
| Volgorde | Alle vragen, chatbots en herhalingen in één willekeurig geschudde lijst, uitgevoerd op 26 september 2026. Uitzondering: 54 Gemini-antwoorden die door een leeg tegoed mislukten, zijn dezelfde dag buiten die volgorde opnieuw gedraaid. Zonder die 54 blijft de hoofdconclusie gelijk: de overlap bij Gemini is dan 52% (49 tot 56%), ook dan bevestigd |
| Totaal | 6.120 antwoorden in het hele onderzoek |
Merken herkennen
De merken in alle antwoorden zijn automatisch herkend door het taalmodel Claude Sonnet 5, met een vaste instructie. Een merk is de naam waaronder een product of dienst wordt aangeboden en gekozen, zoals Moneybird of Coolblue. Overheidsinstellingen en keurmerken tellen niet als merk. Productnamen worden teruggebracht tot het merk: iPhone telt als Apple.
Vóór de meting hebben we die herkenning vergeleken met een tweede model, Claude Opus 5.5, op 150 proefantwoorden. De overeenstemming (F1-score, een maat van 0 tot 1) was 0,95 bij ChatGPT, 0,94 bij Gemini en 0,95 bij Perplexity. Dat is de overeenstemming tussen twee modellen, niet het aandeel correct herkende merken. Een automatische tekstcontrole keek daarna of de naam zoals die in het antwoord stond, dus vóór het terugbrengen tot het merk (iPhone en niet Apple), letterlijk in de antwoordtekst staat; die verwijderde in de hoofdmeting hooguit 1,3% van de herkende namen.
We herhaalden de herkenning ook twee keer op 100 proefantwoorden. De twee rondes hadden 98% overlap. De herkenning varieert dus veel minder dan de antwoorden van de chatbots. Een harde bovengrens voor de invloed van herkenningsfouten op de overlapcijfers geeft deze test niet.
Hoe we rekenen
Per vraag middelen we de overlap over alle paren van herhalingen. Een paar waarin geen van beide antwoorden een merk noemt, laten we weg: dat gold voor 13% van de paren bij ChatGPT, 4% bij Gemini en 10% bij Perplexity. Een paar waarin één antwoord wel en het andere geen merk noemt, telt als 0% overlap.
Daarna middelen we per categorie en geven we elke categorie hetzelfde gewicht. De intervallen komen uit een bootstrap: we trekken 2.000 keer opnieuw een steekproef van vragen binnen elke categorie en kijken hoe sterk de uitkomst schommelt. Omdat we de hypothese voor drie chatbots toetsen, corrigeren we de p-waarden met de Holm-methode.
Beperkingen van de herhaalde metingen
- API, niet de apps. De apps kunnen anders werken, bijvoorbeeld door geheugen of persoonlijke instellingen.
- Oorzaak van de verschillen niet gemeten. We meten hoe sterk antwoorden verschillen, niet welk deel komt door de manier waarop het model tekst maakt, door wisselende zoekresultaten of door andere processen.
- Merkherkenning door een taalmodel. De controle is gedaan met een tweede model van dezelfde maker, niet door mensen. Gedeelde fouten zijn niet uitgesloten.
- Rol niet door mensen gecontroleerd. Of een merk wordt aanbevolen of alleen genoemd, is door het model bepaald. Daarom is “genoemd” de hoofdmaat.
- Alleen aankoopvragen in de hoofdtoets. Informatieve vragen leveren te weinig merken op.
- Eén meetdag. Variatie over weken of maanden zit hier niet in.
- Modelversies. De modelnamen hebben geen datum. Een stille update door de aanbieder is niet zichtbaar in de gegevens.
Open data
Data en citeerwijze van het onderzoek naar merkvermeldingen
De preregistratie (10.5281/zenodo.22974863) en het datadepot (10.5281/zenodo.23010967) staan op Zenodo. De antwoorden, merkextracties en analysescripts staan in het datadepot. Voor deze pagina zijn drie aanvullende analyses berekend: de overlap zonder paren met één leeg antwoord, het aandeel per chatbot van de merken die maar één chatbot noemt, en dezelfde telling met 8 herhalingen per chatbot. Die staan ook in het datadepot.
De data staan onder CC BY 4.0, de analysescripts onder MIT.
Preregistratie en data op Zenodo
Citeer dit onderzoek
Timmermans, M. (2026). Dezelfde aankoopvraag levert bij chatbots deels andere merken op. Timmermans Media. Preregistratie: doi.org/10.5281/zenodo.22974863. Data: doi.org/10.5281/zenodo.23010967. Licentie CC BY 4.0.
Dit onderzoek is beschikbaar onder de CC BY 4.0-licentie.
Veelgestelde vragen
Vragen over merkvermeldingen in ChatGPT, Gemini en Perplexity
Waarom geeft een chatbot bij dezelfde vraag andere merken?
Taalmodellen stellen hun antwoord bij elke vraag opnieuw samen, ook bij exact dezelfde vraag. Bij zoeken kunnen daarnaast de zoekresultaten per keer verschillen. Dit onderzoek meet hoe groot de verschillen zijn, niet welk deel door welke oorzaak komt.
Hoe vaak moet ik een vraag stellen om merkzichtbaarheid te meten?
Een vast minimum heeft dit onderzoek niet bepaald. Wel laat het zien dat drie herhalingen, gemiddeld per vraag, bij ongeveer een kwart van de merken een sterk afwijkende schatting opleverden. Hoe vaker je meet, hoe kleiner de onzekerheid.
Mijn merk staat niet in een antwoord. Word ik dan niet genoemd?
Dat zegt één antwoord niet. Van alle merken uit twee antwoorden op dezelfde vraag stond gemiddeld 38 tot 52% in beide. Een merk dat in één antwoord ontbreekt, kan in het volgende wel staan.
Geldt dit ook als ik de vraag in de app stel?
Dat hebben we niet onderzocht. We maten via de API's met standaardinstellingen. In de apps kunnen geheugen, eerdere gesprekken en persoonlijke instellingen meespelen.
Zijn jullie andere onderzoeken dan wel betrouwbaar, met drie herhalingen?
Die publicaties beantwoorden andere vragen en combineren gegevens uit veel vragen of websites. Dit onderzoek bewijst niet dat drie herhalingen voor al die uitkomsten voldoende zijn. Bij die publicaties staan intervallen bij de hoofdcijfers, en cijfers per categorie en losse voorbeelden zijn als verkennend vermeld.
Kan ik dit voor mijn eigen merk laten meten?
Ja. Met dezelfde meetopzet kunnen we per branche meten hoe vaak en hoe stabiel jouw merk wordt genoemd in ChatGPT, Gemini en Perplexity. Bekijk onze GEO-dienst.
Verwant onderzoek
Onderzoek · zelfde meting
Reddit als AI-bron: ChatGPT vindt het vaak, maar citeert het bijna nooit
Dezelfde meting, met de focus op Reddit en op gevonden tegenover geciteerde bronnen.
Onderzoek · zelfde meting
Pagina's in de Google top 3 worden zelden door ChatGPT geciteerd
Dezelfde 400 vragen naast de Google-resultaten van dezelfde dag.
Onderzoek · zelfde meting
Ook websites met weinig Google-verkeer worden door AI geciteerd
Dezelfde 400 vragen, met van elke geciteerde website het geschatte Google-verkeer.
Onderzoek · zelfde meting
Bij de meeste websites die ChatGPT en Gemini citeren, vonden we geen llms.txt
Dezelfde meting: bij 3.048 geciteerde en niet-geciteerde websites gecontroleerd of ze een llms.txt hebben.

Verschijnt jouw website als bron in AI?
Meet je zichtbaarheid in AI-antwoorden
Wij meten voor jouw branche en regio of je website als bron verschijnt in ChatGPT, Gemini en Perplexity, en welke websites de chatbots wel citeren.