Onderzoek · 8 oktober 2026
Bij de meeste websites die ChatGPT en Gemini citeren, vonden we geen llms.txt
400 Nederlandse vragen zonder merknaam, 3 herhalingen per chatbot, gemeten via de API's van ChatGPT en Gemini. Bij 3.048 websites controleerden we of ze een llms.txt hebben: de websites die als bron werden vermeld, en de websites uit de Google top 10 die niet werden geciteerd.
Matt Timmermans, Timmermans Media. Meting: 26 september 2026. Preregistratie: doi.org/10.5281/zenodo.22974863. Data: doi.org/10.5281/zenodo.23010967.
Bij 22,4% van de gecontroleerde websites die ChatGPT of Gemini als bron vermeldden, vonden we een llms.txt. Bij de websites uit de Google top 10 die niet werden geciteerd, was dat 25,4%. Ook bij 16 van de 20 meest geciteerde websites, waaronder Consumentenbond, ANWB en Rijksoverheid, troffen we het bestand niet aan.
Websites worden dus volop geciteerd zonder dat we een llms.txt aantroffen. Of het bestand de kans op een bronvermelding verandert, hebben we niet gemeten. De uitkomsten gelden voor de API's op 26 september 2026.
De uitkomsten
llms.txt bij geciteerde websites: drie cijfers
22,4% tegenover 25,4%:
bij zoveel van de gecontroleerde geciteerde websites vonden we een llms.txt, tegenover de niet-geciteerde websites uit de Google top 10.
16 van de 20:
bij zoveel van de meest geciteerde websites troffen we geen llms.txt aan, ook niet op vier andere gangbare plekken.
151 van de 610:
in zoveel gevonden bestanden stond een herkenbare vermelding van een SEO-plugin voor WordPress, het vaakst Yoast SEO (aanvullend).
Begrip
Wat is een llms.txt-bestand?
Een llms.txt is een tekstbestand in de hoofdmap van een website, bereikbaar op /llms.txt. Het bevat een korte samenvatting van de website en links naar de belangrijkste pagina's, in een eenvoudige opmaak (Markdown). Het idee is dat taalmodellen zo sneller zien waar een website over gaat.
Het formaat is in september 2024 voorgesteld door Jeremy Howard van Answer.AI. Het is geen officiële standaard. Google schrijft in zijn handleiding voor generatieve AI-functies in Google Search dat Google Search llms.txt-bestanden negeert: een llms.txt helpt en schaadt de zichtbaarheid in Google Search niet. Wel mag je het bestand maken voor andere diensten die het gebruiken. Die uitspraak gaat over Google Search, niet over de Gemini API die wij onderzochten.
Een llms.txt wordt vaak aangeraden als manier om door AI geciteerd te worden. Wij keken of geciteerde websites het bestand vaker hebben.
Wat we als “llms.txt aanwezig” tellen: de website geeft op /llms.txt een tekstbestand terug, geen webpagina, met minstens één kop of link. Veel websites geven op elk onbekend adres een gewone webpagina terug; die tellen niet mee.
Vergelijking
Hebben geciteerde websites vaker een llms.txt dan niet-geciteerde?
In deze meting niet. Bij de gecontroleerde geciteerde websites vonden we in 22,4% een llms.txt, bij de niet-geciteerde websites uit de Google top 10 in 25,4%. De intervallen overlappen. Dit was vooraf vastgelegd als beschrijvende vraag, zonder toets. Omgekeerd: bij 78% van de gecontroleerde geciteerde websites (1.033 van de 1.331) vonden we op /llms.txt geen bestand met herkenbare inhoud.
| Geciteerd door ChatGPT of Gemini | In de Google top 10, niet geciteerd | |
|---|---|---|
| Websites | 1.585 | 1.463 |
| Niet te controleren (geblokkeerd, verbinding afgebroken, time-out) | 254 | 237 |
| Gecontroleerd | 1.331 | 1.226 |
| llms.txt aanwezig | 22,4% (20,3 tot 24,6%) | 25,4% (22,9 tot 28,0%) |
| Niet gevonden (foutcode) | 69,7% | 66,4% |
| Webpagina in plaats van llms.txt | 7,3% | 7,8% |
| Aanwezig, maar zonder kop of link | 0,1% | 0,0% |
| Leeg bestand | 0,5% | 0,3% |
Percentages van de gecontroleerde websites. Elke website telt één keer, hoe vaak die ook geciteerd is. Tussen haakjes het 95%-interval; dat houdt geen rekening met samenhang tussen websites binnen dezelfde vraag en is daarom alleen beschrijvend. Verschillen zijn berekend met niet-afgeronde cijfers.
Per chatbot: van de gecontroleerde websites die ChatGPT citeerde, had 20,6% een llms.txt (122 van 592); bij Gemini was dat 22,9% (202 van 883). Een website die beide citeerden, telt in beide groepen (aanvullend, niet gepreregistreerd).
We concluderen niet dat geciteerde websites minder vaak een llms.txt hebben. Het verschil is klein, niet getoetst, en de twee groepen bestaan uit verschillende soorten websites. Als de niet-geciteerde groep dezelfde verdeling over soorten websites had gehad als de geciteerde groep, was het aandeel daar 23,8% geweest in plaats van 25,4% (aanvullend, niet gepreregistreerd). Het verschil met 22,4% wordt daardoor kleiner: 1,4 in plaats van 3,1 procentpunt. Een deel van het verschil komt dus door de samenstelling van de groepen. Twee geciteerde websites vielen buiten de herweging, youtube.com (video) en tweakers.net (gemengd: forum, nieuws en vergelijker), omdat die soorten bij de gecontroleerde niet-geciteerde websites niet voorkwamen.
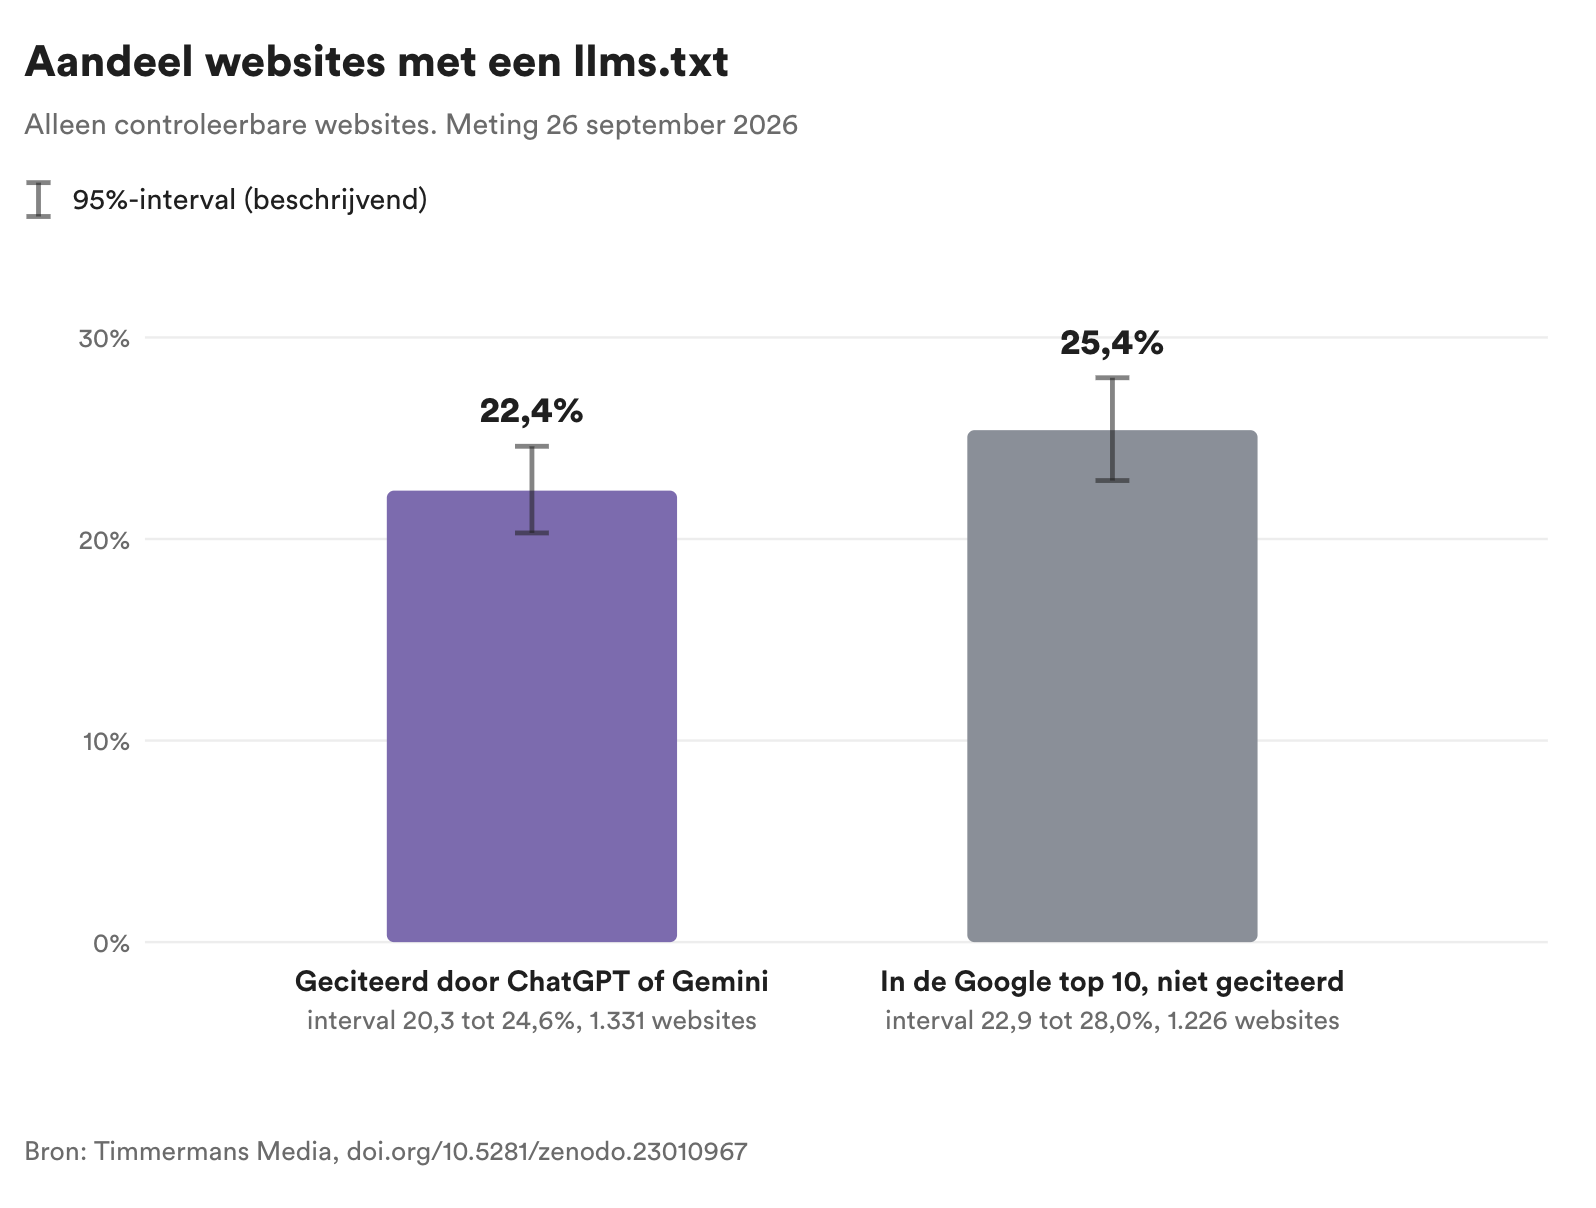
Grafiek 1. Aandeel van de gecontroleerde websites waarbij we een llms.txt aantroffen: geciteerd door ChatGPT of Gemini 22,4% (298 van 1.331, 95%-interval 20,3 tot 24,6%) en in de Google top 10, niet geciteerd 25,4% (312 van 1.226, 22,9 tot 28,0%). Alleen controleerbare websites; elke website telt één keer. Het interval is beschrijvend. Meting 26 september 2026.
Top 20
Welke van de meest geciteerde websites hebben een llms.txt?
Bij vier van de twintig vonden we er een: KVK, e-Boekhouden.nl, Moneybird en Univé. Bij de andere 16 troffen we geen llms.txt aan, ook niet op vier andere gangbare plekken.
| Plaats | Website | Aantal antwoorden als bron | llms.txt |
|---|---|---|---|
| 1 | consumentenbond.nl | 180 | Nee |
| 2 | anwb.nl | 136 | Nee |
| 3 | rijksoverheid.nl | 121 | Nee |
| 4 | voedingscentrum.nl | 76 | Nee |
| 5 | google.com | 68 | Nee |
| 6 | belastingdienst.nl | 65 | Nee |
| 7 | independer.nl | 47 | Nee |
| 8 | kvk.nl | 47 | Ja |
| 9 | overheid.nl | 42 | Nee |
| 10 | thuisarts.nl | 35 | Nee |
| 11 | overstappen.nl | 34 | Nee |
| 12 | trustoo.nl | 30 | Nee |
| 13 | youtube.com | 29 | Nee |
| 14 | tweakers.net | 26 | Nee |
| 15 | werkspot.nl | 25 | Nee |
| 16 | ikea.com | 22 | Nee |
| 17 | e-boekhouden.nl | 21 | Ja |
| 18 | moneybird.nl | 21 | Ja |
| 19 | unive.nl | 21 | Ja |
| 20 | geld.nl | 18 | Nee |
Aantal basisantwoorden van ChatGPT en Gemini samen waarin de website als bron voorkomt. “Nee” betekent dat we op de gecontroleerde locaties geen herkenbaar llms.txt aantroffen: /llms.txt, het www-adres, de map /.well-known/, de submap /nl/ en een docs-subdomein. Niet alle locaties waren bereikbaar; een docs-subdomein bestond bij de meeste niet.
Consumentenbond, ANWB en Rijksoverheid worden 121 tot 180 keer als bron vermeld, terwijl we bij hen geen llms.txt aantroffen. Dat laat zien dat het bestand geen voorwaarde is. Het zegt niet dat een llms.txt geen effect kan hebben: daarvoor zou je dezelfde websites met en zonder bestand moeten vergelijken.
SEO-plugins
Hoeveel llms.txt-bestanden noemen een SEO-plugin?
In 151 van de 610 gevonden bestanden (24,8%) herkenden we een vaste vermelding van een SEO-plugin voor WordPress. Bestanden zonder zo'n herkenbare vermelding vallen buiten deze telling.
| Plugin | Bestanden | Aandeel van de 610 |
|---|---|---|
| Yoast SEO | 96 | 15,7% |
| Rank Math | 42 | 6,9% |
| All in One SEO | 13 | 2,1% |
| Minstens één plugin | 151 | 24,8% |
Aanvullend, achteraf toegevoegd en niet gepreregistreerd. Geteld is de vaste zin “Generated by ...” of “Gegenereerd door ...” in de eerste 2.000 tekens van het bestand; een losse vermelding van een pluginnaam telt niet. Geen enkel bestand noemt meer dan één plugin. De telling is niet handmatig gecontroleerd.
Bij niet-geciteerde websites kwam een pluginbestand iets vaker voor: 85 van de 312 websites met een llms.txt (27,2%), tegenover 66 van de 298 geciteerde (22,1%).
De vermelding zegt iets over het programma dat het bestand vermoedelijk heeft gemaakt, niet over de vraag of de eigenaar het bewust heeft aangezet.
Voor SEO-specialisten
Wat betekent dit voor je advies over llms.txt?
Maak een llms.txt geen vereiste in een advies over zichtbaarheid in AI, en presenteer het niet als bewezen manier om vaker geciteerd te worden. Of het bestand helpt, hebben we niet gemeten. Dit onderzoek levert dus geen bewijs voor of tegen een llms.txt.
| Werkzaamheden | Toepassing van dit onderzoek |
|---|---|
| Klantadvies | Presenteer een llms.txt niet als vereiste of bewezen middel voor meer bronvermeldingen. Bij de meest geciteerde websites troffen we het bestand meestal niet aan. |
| Technische audit | Kijk of een SEO-plugin al een llms.txt aanmaakt, en of de inhoud daarvan klopt. In bijna een kwart van de gevonden bestanden stond een pluginvermelding. |
| Concurrentieanalyse | Gebruik de aanwezigheid van een llms.txt niet als verklaring voor de bronvermeldingen van een concurrent. |
| Rapportage | Meet bronvermeldingen per chatbot rechtstreeks, in plaats van een llms.txt als graadmeter te gebruiken. |
Dit geldt voor Nederlandse vragen via de API's, gemeten op één dag.
Welke websites ChatGPT en Gemini wel als bron gebruiken, lees je in ons onderzoek naar Reddit als AI-bron. Hoe vaak een pagina uit de Google top 3 als bron terugkomt, lees je in ons onderzoek naar Google-posities en AI-bronnen. Of ook websites met weinig Google-verkeer geciteerd worden, lees je in ons onderzoek naar Google-verkeer van AI-bronnen.
Verdieping
Verdieping: llms.txt per soort website
Merken en webshops hebben het vaakst een llms.txt (27 tot 28%), overheidswebsites en nieuwsmedia het minst (4 tot 9%). Bij geciteerde en niet-geciteerde websites liggen de aandelen per soort meestal dicht bij elkaar.
| Soort website | Geciteerd: met llms.txt | Niet geciteerd: met llms.txt |
|---|---|---|
| Merk of webshop | 27,4% (843) | 28,4% (799) |
| Vergelijker of affiliate | 23,4% (192) | 26,5% (151) |
| Vakblog | 14,1% (64) | 25,2% (163) |
| Nieuwsmedia | 8,9% (56) | 4,0% (25) |
| Overheid en instelling | 4,3% (164) | 4,5% (67) |
Verkennend. Soort website bepaald door een taalmodel, zonder menselijke controle. Percentages van de gecontroleerde websites van die soort; tussen haakjes het aantal gecontroleerde websites. De vijf soorten samen zijn 1.319 van de 1.331 geciteerde en 1.205 van de 1.226 niet-geciteerde websites. De overige 12 geciteerde websites zijn forums (2), reviewplatforms (4), overig (4), video (1) en tweakers.net (1); de overige 21 niet-geciteerde zijn forums (13), social media (3), reviewplatforms (2), naslagwerken zoals Wikipedia (2) en overig (1). In de herweging zijn ze meegenomen, behalve de video-website en tweakers.net; social media en naslagwerken komen bij de geciteerde websites niet voor en wegen daardoor niet mee.
De grootste verschillen zitten bij vakblogs en nieuwsmedia, maar daar gaat het om kleine aantallen. Overheidswebsites en instellingen leveren bij ChatGPT de meeste bronvermeldingen: 48% van alle bronvermeldingen, inclusief Consumentenbond en ANWB. Als verschillende websites zijn ze een kleinere groep: 164 van de 1.331 gecontroleerde geciteerde websites. Bij 4,3% daarvan vonden we een llms.txt.
Verantwoording
Werkwijze: llms.txt controleren bij ruim 3.000 websites
Wat vooraf was vastgelegd
Dit onderdeel stond in de preregistratie als beschrijvende vraag, zonder toetsbare hypothese (DOI 10.5281/zenodo.22974863). Vooraf vastgelegd waren de controle, de zes uitkomstklassen, de vergelijkingsgroep en een extra controle van de 20 meest geciteerde websites zonder llms.txt.
Afwijkingen, controle per website, valse treffers en beperkingen
De telling van pluginbestanden is een aanvullende analyse die achteraf is toegevoegd. De telregels zijn vastgelegd voordat het script draaide, maar nadat we de bestanden tijdens een eerdere controle hadden bekeken. Regels, script en uitkomsten staan in het datadepot.
De preregistratie noemde een handmatige controle van 20 websites. We hebben dat vervangen door een vaste automatische controle van vier extra locaties. Geselecteerd zijn de 20 meest geciteerde websites waar op /llms.txt geen bestand stond; ook websites met een webpagina, een leeg bestand of zonder bruikbaar antwoord telden daarbij als “geen bestand”. Zestien daarvan vallen in de top 20 hierboven. Deze vervanging is gelogd als afwijking. Bij een van de 20, facebook.com, kwam ook op de extra plekken grotendeels geen antwoord; daar is dus niet vastgesteld dat er geen llms.txt is.
Na het deponeren zijn op 26 september 2026 twee regels aangepast, beide voordat er analyses waren gedaan. Amendement 1 (een tweede pagina Google-resultaten voor 88 zoektermen) bepaalt mee welke websites in de vergelijkingsgroep uit de Google top 10 vallen. Amendement 2 gaat over Ahrefs-gegevens en raakt deze publicatie niet. Beide staan in het amendementenlog in het datadepot.
Hoe we elke website controleerden
| Onderdeel | Invulling |
|---|---|
| Welke websites | Alle websites die ChatGPT of Gemini in de basismeting als bron vermeldden (1.585), en alle websites uit de Google top 10 van de 400 zoektermen die ChatGPT en Gemini niet citeerden (1.463). 64 van die 1.463 werden in latere herhaalmetingen wel geciteerd; de indeling volgt de basismeting |
| Verzoek | Eén verzoek per website naar https://[website]/llms.txt, met een herkenbare naam van Timmermans Media, hooguit 5 doorverwijzingen, 10 seconden wachttijd |
| Moment | 26 september 2026 (19:41 tot 20:10 UTC), extra controles op 27 september 2026 |
| Uitkomst | Zes klassen: aanwezig met herkenbare inhoud, aanwezig zonder herkenbare inhoud, leeg, webpagina (HTML), afwezig, niet te controleren |
Uitsluiten van valse treffers
We wilden uitsluiten dat websites op elk adres dezelfde tekst teruggeven en daardoor ten onrechte als “aanwezig” tellen. Daarom vroegen we bij alle websites met een llms.txt in de volledige meting (1.630 websites, waaronder de 610 uit deze vergelijking) ook een adres op dat niet kan bestaan. Bij geen enkele website kwam daar dezelfde inhoud terug. Deze controle is aanvullend en niet gepreregistreerd.
Websites zonder bruikbaar antwoord
Ongeveer 16% van de websites (491 van de 3.048) gaf geen bruikbaar antwoord, vooral door beveiliging die geautomatiseerde verzoeken blokkeert (foutcode 403) of de verbinding afbreekt. Die websites vallen buiten de percentages. Een hercontrole met een ander programma bij 30 websites met een afgebroken verbinding gaf bij 24 dezelfde fout en bij 5 wel een antwoord. Bij de dertigste kwam binnen 10 seconden geen verbinding tot stand (time-out). De 403-blokkades, de grootste groep, hebben we niet apart gecontroleerd.
Beperkingen van de llms.txt-meting
- Beschrijvend, geen oorzaak. We meten hoe vaak een llms.txt voorkomt, niet of het bestand het citeren beïnvloedt.
- Verschillende groepen. Geciteerde en niet-geciteerde websites verschillen in soort, grootte en onderwerp. Een verschil in llms.txt kan daarmee samenhangen.
- Websiteniveau, ChatGPT en Gemini samen. Elke website telt één keer, hoe vaak die ook geciteerd is.
- Alleen de standaardlocatie. Voor alle websites keken we op /llms.txt. Alleen voor de 20 meest geciteerde websites zonder bestand op die plek keken we op vier extra plekken.
- Eén moment. Websites kunnen na 26 september een llms.txt hebben toegevoegd of verwijderd.
- Niet te controleren websites. 16% kon niet worden gecontroleerd. Als die vaker of minder vaak een llms.txt hebben, verandert het percentage.
- Soort website automatisch bepaald. Door taalmodellen, zonder menselijke controle.
Open data
Data en citeerwijze van het llms.txt-onderzoek
De preregistratie (10.5281/zenodo.22974863) en het datadepot (10.5281/zenodo.23010967) staan op Zenodo. De resultaten van de controle per website en de analysescripts staan in het datadepot.
Ook de aanvullende analyses op deze pagina staan in het datadepot: de plugintelling, de uitsplitsing per chatbot en de herweging naar soort website.
De data staan onder CC BY 4.0, de analysescripts onder MIT.
Preregistratie en data op Zenodo
Citeer dit onderzoek
Timmermans, M. (2026). Bij de meeste websites die ChatGPT en Gemini citeren, vonden we geen llms.txt. Timmermans Media. Preregistratie: doi.org/10.5281/zenodo.22974863. Data: doi.org/10.5281/zenodo.23010967. Licentie CC BY 4.0.
Dit onderzoek is beschikbaar onder de CC BY 4.0-licentie.
Veelgestelde vragen
Vragen over llms.txt en AI-bronvermeldingen
Heb ik een llms.txt nodig om door AI geciteerd te worden?
Nee. Bij de meeste websites die ChatGPT en Gemini in deze meting citeerden, vonden we er geen, waaronder 16 van de 20 meest geciteerde. Of een llms.txt de kans op een bronvermelding vergroot, hebben we niet gemeten.
Moet ik mijn llms.txt verwijderen?
Dit onderzoek geeft geen reden om je llms.txt te verwijderen. We hebben niet onderzocht of toevoegen of verwijderen invloed heeft op bronvermeldingen.
Lezen AI-systemen een llms.txt?
Dat kunnen we met deze data niet zeggen. We meten of geciteerde websites er een hebben, niet of een AI-systeem het bestand leest.
Waarom hebben zoveel websites een llms.txt?
Deels door SEO-plugins voor WordPress die het bestand kunnen aanmaken. In 151 van de 610 gevonden bestanden stond een herkenbare vermelding van Yoast SEO, Rank Math of All in One SEO.
Kan ik laten meten of mijn website als bron verschijnt in AI?
Ja. Met dezelfde meetopzet kunnen we meten of jouw website in ChatGPT, Gemini en Perplexity als bron verschijnt. Bekijk onze GEO-dienst.
Verwant onderzoek
Onderzoek · zelfde meting
Dezelfde aankoopvraag levert bij chatbots deels andere merken op
Dezelfde meting: 60 aankoopvragen elk 8 keer gesteld, om te zien hoe sterk de genoemde merken per antwoord wisselen.
Onderzoek · zelfde meting
Ook websites met weinig Google-verkeer worden door AI geciteerd
Dezelfde 400 vragen, met van elke geciteerde website het geschatte Google-verkeer. Veel van deze websites worden geciteerd, maar elk maar in een paar antwoorden.
Onderzoek · zelfde meting
Pagina's in de Google top 3 worden zelden door ChatGPT geciteerd
Dezelfde 400 vragen naast de Google-resultaten van dezelfde dag.
Onderzoek · zelfde meting
Reddit als AI-bron: ChatGPT vindt het vaak, maar citeert het bijna nooit
Dezelfde meting, met de focus op Reddit en op gevonden tegenover geciteerde bronnen.

Verschijnt jouw website als bron in AI?
Meet je zichtbaarheid in AI-antwoorden
Wij meten voor jouw branche en regio of je website als bron verschijnt in ChatGPT, Gemini en Perplexity, en welke websites de chatbots wel citeren.